14 ago 2026
Se il server è offline, la fabbrica deve fermarsi?
Progettare sistemi industriali distribuiti assumendo che la rete, prima o poi, cadrà
In uno scenario industriale, può emergere l’esigenza di vincolare il funzionamento della macchina alla corretta immissione dei dati da parte di un’operatore in linea. Detta così sembra un problema piuttosto semplice da risolvere: quando i dati non sono compilati correttamente si scrive una variabile in macchina che, opportunamente predisposta, ferma il ciclo di lavoro.
Non è tanto questa semplice automazione a preoccuparmi, quanto più tutto ciò che ne consegue. Si presuppone infatti che il sistema in fase di realizzazione sia sempre disponibile e questo ahimè non può essere sempre vero.
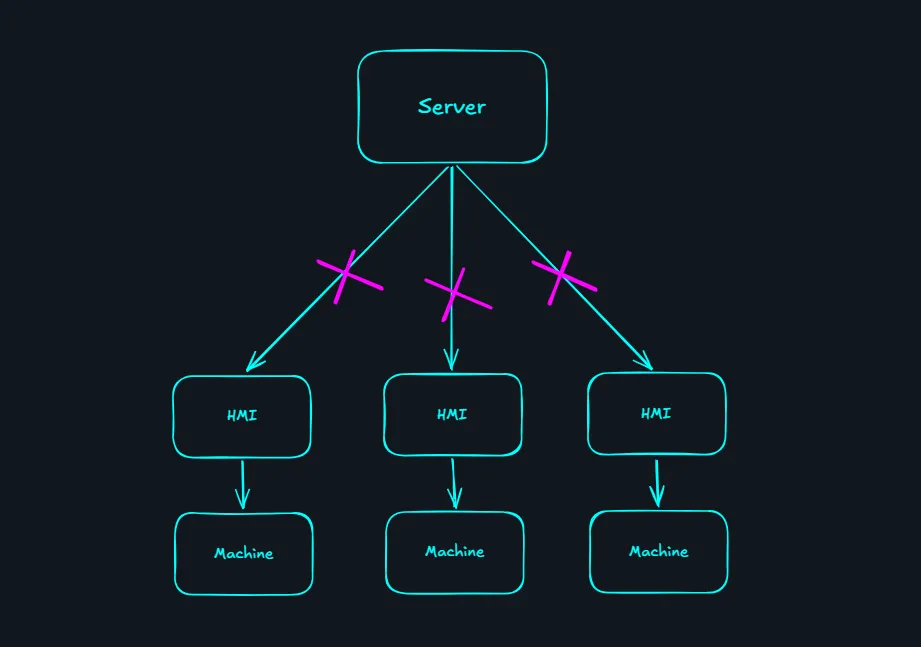
In impianto infatti possono verificarsi imprevisti: assenza di connettività internet, problemi sulla rete interna e molto altro. In questa condizione, è accettabile che la macchina e quindi **la produzione si debba fermare? Ovviamente non può essere così.
In un’architettura classica, si prevede solitamente di installare un server nel quale è presente un database. I vari dispositivi ed interfacce distribuite si collegano ad esso tramite connessioni http alle varie api rest.
A questo punto ci si deve assicurare che il sistema sia resiliente a tutto questo genere di imprevisti. Questo implica una serie di scelte non solo architetturali, ma anche infrastrutturali. Se installassimo il sistema su di un pannello HMI, dovremmo assicurarci per lo meno:
- che la macchina sia sempre raggiungibile dal pannello
- che le anagrafiche a bordo del pannello siano sempre allineate con quelle distribuite dal gestionale ERP
- che i dati prodotti dal sistema siano recuperabili, anche dopo un offline prolungato
Per la prima problematica, quelle della raggiungibilità macchina, dobbiamo iniziare a pensare anche all’infrastruttura. Idealmente dovremmo avere una comunicazione dedicata su rete isolata tra pannello e macchina. In alternativa o analogamente, possiamo pensare che il pannello possegga due schede di rete, una verso la macchina, una verso la rete locale. La prima è prerogativa imprescindibile per il funzionamento del sistema, la seconda può anche non funzionare.
La seconda problematica, quella dell’allineamento delle anagrafiche, è invece risolvibile a livello architetturale. Possiamo infatti immaginare dei meccanismi che permettano un allineamento, il più frequente possibile. Chiaramente in questo caso ci dovremo accontentare di una consistenza eventuale, anzichè di una consistenza perfetta con il sistema centrale. Questo significa che durante un periodo di offline lo stato del pannello potrà divergere da quello del sistema centrale. Sarà quindi necessario considerare questa divergenza durante la successiva riconciliazione dei dati. Non tutti i dati, però, hanno lo stesso requisito di consistenza: possiamo tollerare che un’anagrafica non sia immediatamente aggiornata, mentre non possiamo accettare di perdere un evento di produzione già avvenuto.
Si introducono poi delle ulteriori problematiche:
- peso della comunicazione verso ogni singolo pannello durante le fasi di allineamento anagrafica
- storage sul pannello delle anagrafiche di sistema
Infine la terza problematica, come gestire l’immagazzinamento dei dati durante l’offline? In questo caso una scelta può essere quella di utilizzare code con persistenza attiva. La scelta deve tenere conto di diversi aspetti: persistenza dei messaggi, velocità di scrittura, acknowledgement e possibilità di ritentare la consegna in caso di errore.
Una coda persistente ci permette di non perdere gli eventi durante l’offline, ma non risolve automaticamente il problema della sincronizzazione.
In questo caso durante il recupero della connessione ci si dovrà occupare dell’invio dei messaggi immagazzinati in coda. È imprescindibile che tali operazioni siano idempotenti: Se il pannello invia un evento e la connessione cade prima di ricevere l’acknowledgement, come può sapere se il server ha realmente ricevuto il messaggio? La strategia più sicura è ritentare, ma questo significa accettare che lo stesso evento possa arrivare più volte. Da qui la necessità di identificare univocamente gli eventi e rendere idempotente la loro elaborazione.
E per quanto riguarda l’orario degli eventi? Qual è la fonte della verità temporale?
Un evento ha almeno due riferimenti temporali: il momento in cui è avvenuto e il momento in cui è stato ricevuto dal server. Durante un periodo di offline questi due istanti possono essere molto distanti tra loro.
Il pannello deve quindi poter registrare autonomamente l’orario dell’evento. Dobbiamo però assicurarci che gli orologi dei diversi dispositivi siano continuamente allineati. Un NTP server può aiutarci a mantenere una sorgente temporale comune, ma non risolve completamente il problema.
Quando gli eventi raggiungono il server principale, si deve infatti distinguere il momento in cui l’evento è realmente avvenuto dal momento in cui è stato ricevuto e considerare eventuali differenze tra gli orologi dei dispositivi.
Un’architettura di questo tipo introduce ulteriori sfide, come ad esempio la gestione del deploy su pannelli distribuiti, ma di questo ne parlerò in un successivo articolo.
La struttura descritta può essere definita “offline-first”. Ma cosa significa davvero in ambito industriale? In un’applicazione tradizionale, “offline” si traduce in un sistema non raggiungibile. In ambito industriale distribuito invece vuol dire che parte del sistema deve continuare ad essere un sistema. Questo cambia completamente il modo in cui dobbiamo progettare infrastruttura, dati, eventi, sincronizzazione e consistenza. Offline-first significa progettare un sistema assumendo che la rete, prima o poi, cadrà.